コメント
[?]bot確認
まだコメントはありません。
まだコメントはありません。
このブログでは、デプロイスクリプトの堅牢化、セキュリティヘッダー、lintの整理、管理コンソールの分割、コンポーネント構成のatoms / molecules / organisms再編を、小さな変更の連続として進めました。
大規模リファクタリングを「一気に書き換える作業」にすると、構造変更と挙動変更が混ざり、失敗時に原因を特定できません。
この記事は変更一覧ではなく、外から見える挙動を保ちながら進めるための6つのガードレールです。
重要なのはテストの本数ではありません。
どの契約を守るテストなのか、どの段階でどのゲートを実行するのか、失敗時にどこまで戻すのかを明確にします。
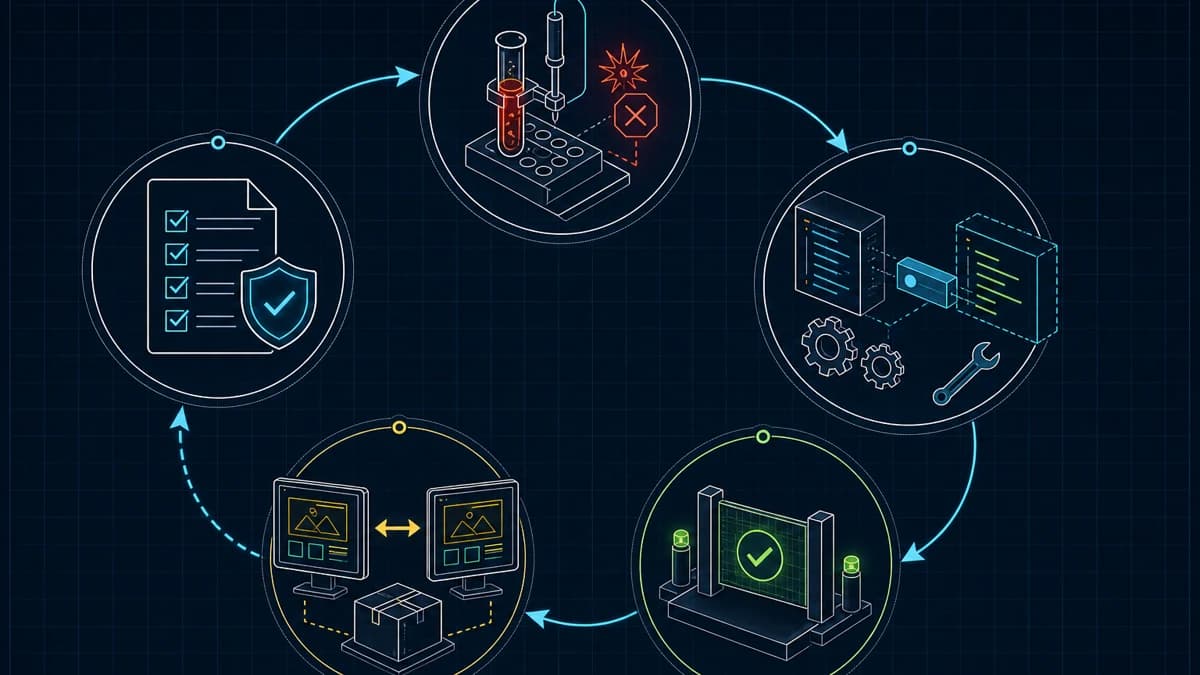
*図: 外部挙動をテストで固定し、根本原因ごとに小さく変更して同じ結果を再確認する。*
管理コンソールを分割するとき、ロジックの書き換えとコンポーネント境界の変更を同じコミットへ入れませんでした。
状態とハンドラーはuse-admin-console.ts、一覧・タグ・analytics・設定・運用の表示はパネル、エディターはeditor-panel.tsxへ移します。
admin-console.tsxは現在、コントローラーを取得しパネルを組み立てる薄いオーケストレーターです。
進め方も固定します。
移動中に見つけた改善案は別の分割へ送ります。
「ついでに綺麗にする」を混ぜないと、差分は移植として読め、回帰の原因範囲も狭くなります。
一番危険なのは、コマンドが0で終わったように見えても期待した状態へ到達していない処理です。
このブログのデプロイ ヘルパーはビルド後のWorkerをno-routes設定でアップロードし、バージョン IDを確定してからwrangler versions deployで100%へ切り替えます。
その後にwrangler deployments list --jsonを読み、新バージョンがトラフィックが100%で有効か検証します。
確認できなければ成功扱いにせず例外で停止します。
wrangler deployの人が読む形式の出力だけへ依存するのも危険です。
バージョン IDを取り出せない場合は、アップロード前後のwrangler versions list --jsonを比較し、追加されたバージョンが一意な場合だけ採用します。
曖昧ならデプロイを続けません。
同じ原則はTurnstileにも使います。
サイト key未設定を静かな空欄にせず、サーバーとクライアントの両方へboundedな設定 エラーを記録し、bot protectionが無いのに送信できたような状態を避けます。
static analyzerやAI レビューは、調査候補を増やす道具であって判決ではありません。
例えばSQLiteのMAX(likes - 1, 0)をaggregateのMAX()と混同すると、危険なSQLに見えるかもしれません。
しかしSQLite公式ドキュメントでは、max(X,Y,...)は複数argumentを受けるscalar functionです。
この場合は0を下限にする式として成立します。
報告を受けたら、まず公式spec、現在のソース、最小のreproductionを確認します。
誤検知を直すためにSQLやcontrol フローを変えると、その「修正」が新しいbugになります。
逆に本物の問題なら、再現テストを先に置くことでreviewerと将来の変更者へ根拠を残せます。
ReactのsetState-in-effectをsetTimeoutで包めばwarningを隠せる場合がありますが、それでは同期effectが追加renderを起こす構造は説明できません。
このブログではhydration後だけtrueになる値をuseSyncExternalStoreでサーバー snapshotとクライアント snapshotへ分けました。
ただしuseSyncExternalStoreは万能な置換ではありません。
props / 状態から導出できる値はrender中に計算し、React内部だけの状態にはuseStateやuseReducerを使います。
外部storeやブラウザ APIなら、immutableなsnapshotと実際のsubscribe / unsubscribe契約を用意します。
同じ文書中に変化しないhydration flagだけはstableなno-op subscriptionを使えます。
例外的なlint disableが必要なら、広いファイル単位ではなく対象1行へ限定し、理由を隣へ残します。
lint zeroは数字を作るgameではなく、データ ソースと更新経路を説明可能にする作業です。
D1のforward-onlyマイグレーション履歴は前進のみです。
適用済みマイグレーション ファイルやd1_migrationsを手で書き換えて履歴だけを戻すと、実スキーマとWranglerの認識が分離します。
ローカルの.down.sql fixtureをリモートへ直接実行する運用もしません。
マイグレーション後の書き込みを残す必要がある部分障害では、問題を修正する新しいforward migration(前進マイグレーション)を作ります。
既存履歴は変更せず、次の番号でスキーマ / データを前進修正します。
データベース全体を適用前へ戻す重大障害では書き込みを停止し、事前に保存したブックマークを二者確認してD1 Time Travelを使います。
復元後は事故マイグレーションが再びpendingになるため、自動化を自動再開しません。
next canaryとeslint-config-nextも同じバージョンへexact pinしています。
upgradeは単独分割にし、失敗時に戻せるバージョン差分と検証結果を残します。
「戻り道」は危険なコマンドを準備することではなく、どのデータを保持し、どのrecovery パスを選ぶかを先に決めることです。
すべての重いゲートを手作業で毎回繰り返すと、feedbackが遅くなり、失敗した根本原因も曖昧になります。
まず各分割で対象を絞ったテストをRED→GREENにし、関連diffだけをステージします。
現在のpre-commit(pre-コミット)は、format、typecheck、unit test(単体テスト)、staged diffのGitleaks、Clawpatch 状態を自動実行します。
一方pre-pushはverify:pushで、format / typecheck / unit test(単体テスト)に加えて管理機能coverage、広告audit、実サーバー E2E、全dependency audit、Clawpatch CIを通し、最後にGitleaks history(履歴)も確認します。
lintは独立コマンドとして0 エラー / 0 warningを維持し、リリース前に確認します。
この層分けなら、日々のdebugではfocused feedbackを先に得つつ、push前にはリポジトリ全体の契約を一度まとめて検証できます。
構造テストがソース パスやpatternの変更で落ちた場合も、本番変更だけでなくテスト 仕様の追従まで同じ根本原因として扱います。
6つのガードレールは次の通りです。
大きなリファクタリングを安全にするのは、巨大な最後のテストではありません。
1つの根本原因、1 対象を絞ったテスト、1 レビュー可能なコミットを積み重ね、リリース境界でfull ゲートを通すことです。