この記事の目次
タップすると同じページ内の見出しへ移動します
10 sections 01 この記事でわかること ↓ 02 coreの全体構成 ↓ 03 D1はauto-コミットとtransactionを区別する ↓ 04 ブラウザ、Imagesのバインディング、R2の責務を重ねる ↓ 05 vinextとNext.jsのバージョンはmanifestどおりに読む ↓ 06 ビルド時とランタイムの設定を混同しない ↓ 07 costはsnapshotとして書く ↓ 08 まとめ ↓ 09 公式参考資料 ↓ 10 関連記事 ↓ この記事でわかること このブログの公開画面と管理APIは、Cloudflare Workers、D1、R2、Cloudflare Images、vinextを組み合わせて動いています。
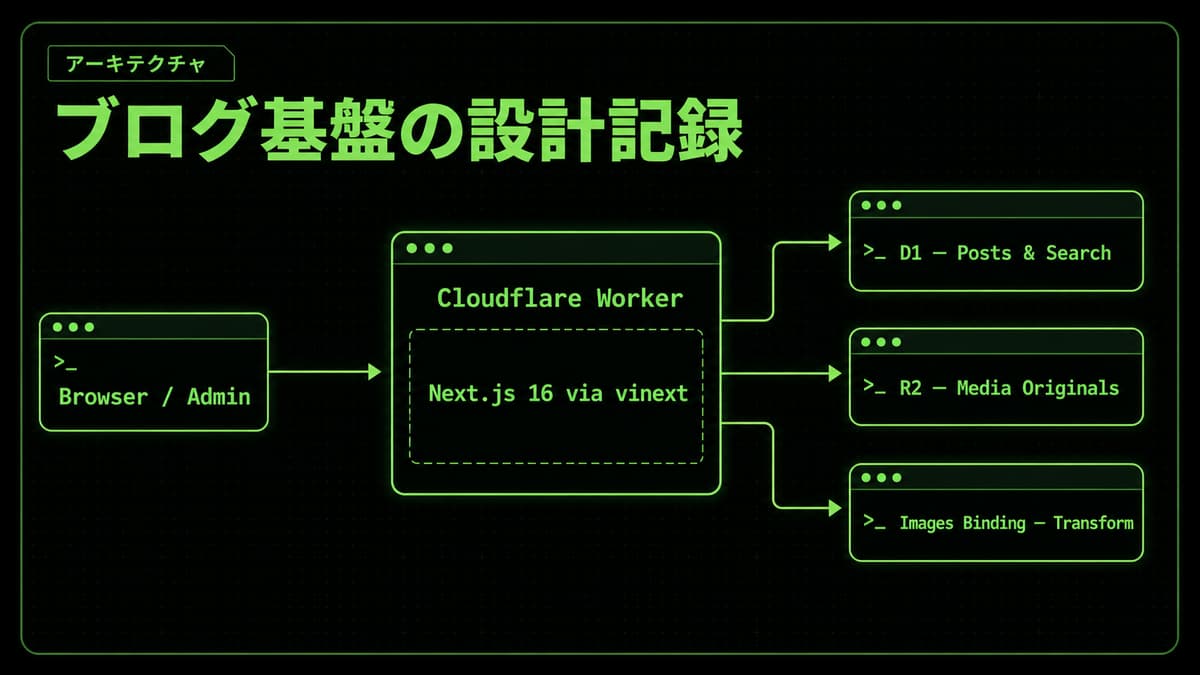
ここでは「全部サーバーレスだから簡単」と丸めず、どのリクエストをどのバインディングへ渡し、どこで整合性を守っているかを実装に沿って説明します。
Cloudflare WorkersはNode.jsの1 プロセスを常駐させる仕組みではありません。
Cloudflare公式説明どおり、V8 isolateでコードを実行する分散ランタイムです。
したがってmodule scopeの可変状態を永続DBの代わりにはできません。
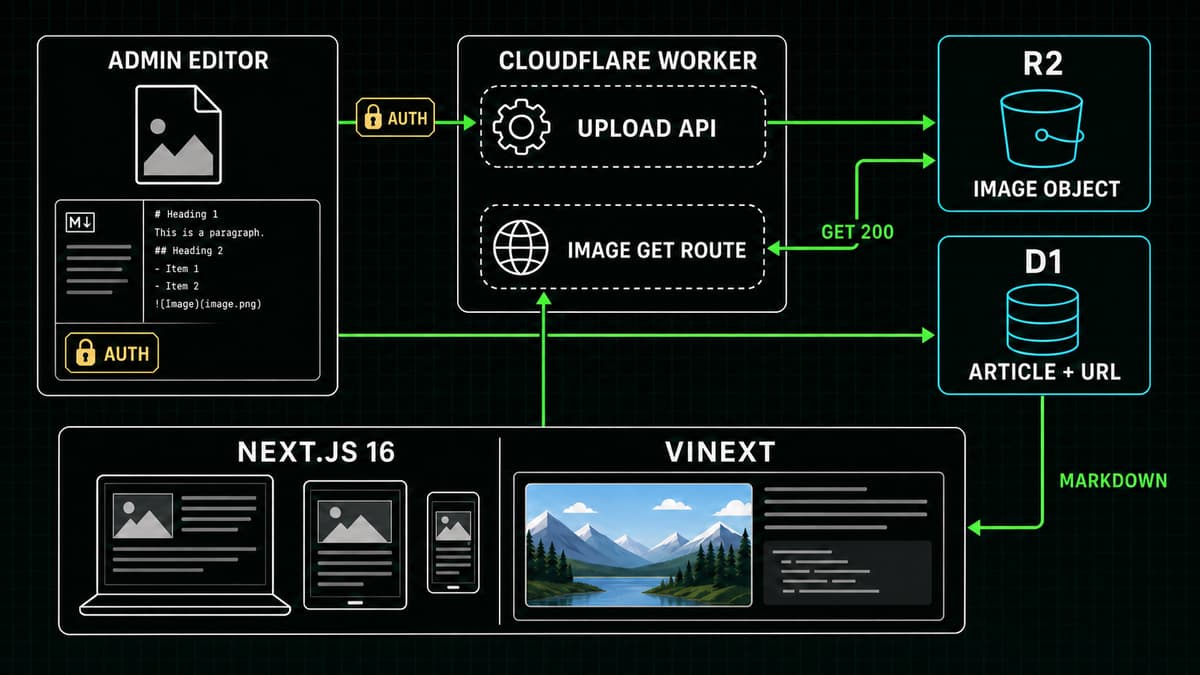
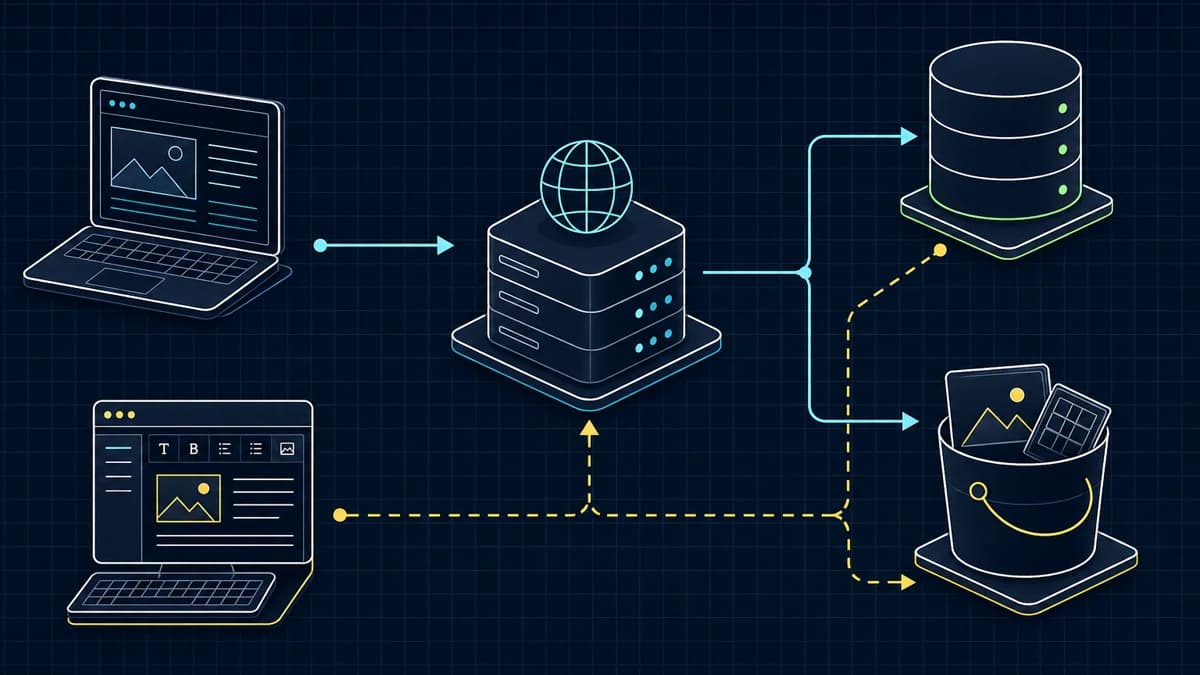
readerとadminのリクエストがedge application、D1、R2を通るブログのデータ フロー *図: 公開閲覧と管理書込みは同じedge applicationを通る一方、D1 rowとR2オブジェクトは別の責務として扱う。*
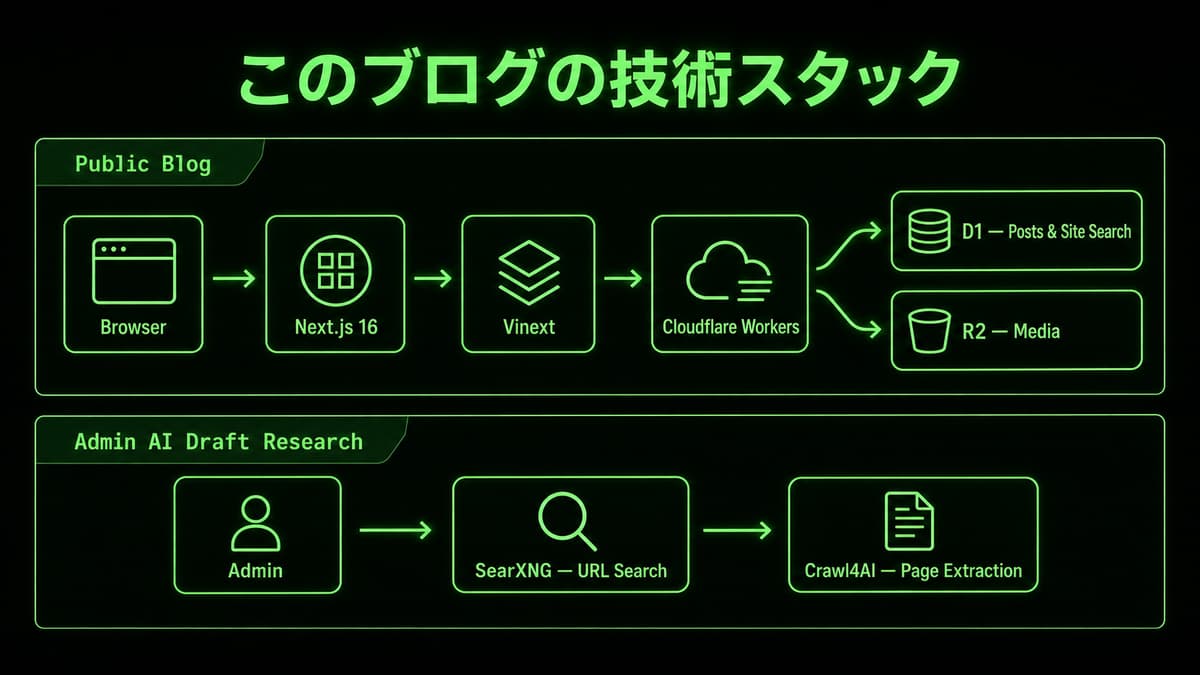
coreの全体構成 txt ⧉
browser
  ├─ static file ──────────────> Workers Assets
  └─ dynamic request
       ▼
1つのWorker deployment(V8 isolateで実行)
  ├─ vinext App Router(SSR + API)
  ├─ D1 binding(記事・コメント・設定・media metadata)
  ├─ R2 binding(thumbnail / article media)
  ├─ Images binding(validation後のresize / encode)
  └─ send_email binding(管理者OTP mail)
動的なSSR、API、 /_vinext/imageは1つのWorker deploymentで扱います。
一方、matchingする静的ファイルはWorkers AssetsがWorker コードより先に返せるため、「全リクエストが同じentry ポイントを通る」とは限りません。
どちらも同一originで公開し、D1、R2、Images、emailは外部REST APIではなくバインディングで呼ぶため、core パスにブラウザのcross-origin CORSを持ち込みません。
ただし、リポジトリ全体が1 Workerだけで閉じているわけでもありません。
管理画面のweb searchはSearXNGとCrawl4AIを外部serviceとして使い、AI生成はDurable オブジェクト経由のCodex containerへ委譲します。
この分離を隠すと、障害範囲とデプロイ対象を誤認します。
D1はauto-コミットとtransactionを区別する 個別文はauto-コミットです。
複数文を1回で送るD1の batch()はtransactionとして実行され、途中で失敗すればsequence全体がabortまたはrollbackされます。
このブログではメディア reservationの検証・消費とメタデータ登録、記事保存と検索索引更新など、同時に成立すべき書き込みを batch()へまとめます。
一方、別リクエストにまたがる「readしてから書き込み」は自動では保護されません。
管理画面で既存記事を更新するときは、読込時のtimestampをpreconditionにした次の形でcompare-and-swapします。
sql ⧉
UPDATE posts SET ... WHERE id = ? AND updated_at = ? 変更row数が0なら、別リクエストによる更新または削除との競合として扱います。
新規作成用の INSERT ... ON CONFLICT DO UPDATEと、既存記事のguard付きupdateを同じ安全性だと考えないことが重要です。
スキーマ例は実スキーマの簡略版です。
最初のマイグレーションには cover、 author、 likes、 viewsもあり、後続マイグレーションで title_ja、 content_enなどのbilingual column、comment、FTS、メディア管理tableが追加されます。
sql ⧉
CREATE TABLE posts (
  id TEXT PRIMARY KEY,
  slug TEXT UNIQUE NOT NULL,
  title TEXT NOT NULL,
  excerpt TEXT NOT NULL,
  content TEXT NOT NULL,
  tags TEXT NOT NULL DEFAULT '[]',
  status TEXT NOT NULL CHECK (status IN ('draft', 'published')),
  cover TEXT NOT NULL DEFAULT '',
  author TEXT NOT NULL,
  likes INTEGER NOT NULL DEFAULT 0,
  views INTEGER NOT NULL DEFAULT 0,
  created_at TEXT NOT NULL,
  updated_at TEXT NOT NULL
);
タグはJSON文字列として保存しています。
記事数が小さい現在は、公開記事の tagsだけを読んでapplication側で正規化・集計する設計です。
規模が変われば、タグ relationを別tableに分ける判断も必要になります。
ブラウザ、Imagesのバインディング、R2の責務を重ねる アップロード前にブラウザは画像を最大幅1600pxへ縮小し、元ファイルより小さくなる場合だけWebPの品質 0.82を採用します。
これは転送量を減らすためのpreprocessingで、security boundaryではありません。
サーバーは受信後にも宣言MIMEと実バイトの実byte signature、5MiB上限を検証します。
通常の記事内画像はImagesのバインディングで最大幅1600px、WebPの品質 82へ変換します。
記事カバー画像(記事cover)だけは別契約で、PNG入力をカバー画像として切り抜いた1200×675 PNGに保存し、変換レスポンスの content-typeと出力signatureも一致しなければfail closed(失敗時は拒否)にします。
その後、事前に確保したD1 ストレージ reservationを検証・消費し、メディアのメタデータ登録と同じ batch() transactionで確定してから、R2へ一時オブジェクトを private, no-storeで保存します。
失敗時はreservation、メタデータ、R2オブジェクトをcleanupする設計です。
配信時の /_vinext/imageは、静的ソースならWorkers Assets、管理メディアなら同一オリジン APIからbytesを取得し、Imagesのバインディングへ渡します。
Cloudflare公式仕様ではImagesのバインディング レスポンスは自動cacheされないため、cacheを語るときはframeworkとレスポンスヘッダーを含む実経路で確認する必要があります。
つまり「ブラウザで圧縮したからサーバーは信頼する」でも、「サーバー変換だけにすべて任せる」でもありません。
ブラウザは転送量、サーバーは検証・正規化、D1はメタデータとquota、R2はオブジェクト保存を担当します。
vinextとNext.jsのバージョンはmanifestどおりに読む このリポジトリはNext.jsAPIの範囲をVite上へ再実装するvinextを使い、App Routerとサーバー Componentsを動かしています。
vinext自身のREADMEはexperimentalでheavy development中と明記しているため、Next.jsと完全互換だとは扱いません。
現在の package.jsonではNext.js canaryをexact指定し、vinextは ^ rangeです。
実際にインストールされるvinext バージョンはlockfileで固定されます。
したがって「両方ともexact pin」と説明するのは誤りです。
upgrade時はrangeだけを信じず、lockfile差分、ビルド、全テスト、Worker ローカル HTTP、Wrangler dry-実行をまとめて確認します。
ビルド時とランタイムの設定を混同しない クライアント bundleへ入る NEXT_PUBLIC_*はビルド時の値です。
D1やR2などのバインディングとサーバー シークレットはランタイムの envから取得します。
このプロジェクトのサーバー ヘルパーはランタイム バインディングを優先し、文字列がなければ環境判定をせず process.envを見ます。
リポジトリではこれをローカル developmentやテストのフォールバックとして使いますが、helper自体はNODE_ENVで制限していません(サーバーヘルパーの制約も同じです)。
ts ⧉
export async function getRuntimeValue(key: keyof BlogRuntimeEnv) {
  const runtime = getCloudflareEnv()?.[key];
  if (typeof runtime === "string" && runtime.length > 0) return runtime;
  const nodeValue = process.env[key];
  return nodeValue && nodeValue.length > 0 ? nodeValue : undefined;
}
公開値とシークレットを同じものとして扱わず、シークレットはWrangler secret、バインディングはWrangler 設定、クライアント公開値はビルド結果まで確認します。
costはsnapshotとして書く この設計はfree plan内の運用を目標にしていますが、この記事だけではaccountの実利用量や請求状態を確認できません。アカウント(account)の利用量は別途ダッシュボードで確認します。
WorkersはリクエストとCPU、D1はストレージとrows read/書き込み、R2はストレージとoperation class、Imagesはunique transformationなど、課金軸が分かれます。
料金と上限は変わるため、「永久にdomain代だけ」とは断定せず、billing dashboardと公式pricingを定期確認します。
まとめ Cloudflare Workersは1 プロセスではなくV8 isolateで実行される coreの動的パスは1 Worker deployment、static ファイルはWorkers Assets、追加AI/searchは別serviceにも依存する D1の batch() transactionと、リクエスト間競合を防ぐguard付き書き込みは別の問題である ブラウザ、Imagesのバインディング、D1、R2に画像処理の責務を分ける package manifestとlockfileを見て、実際のバージョン固定方法を説明する ビルド時公開値とランタイム バインディング・シークレットを分離する 公式参考資料 関連記事